
快訊
- 亞運》李洋遭阻擋入選手村 OCA主席說話了
- 【顧爾德專欄】AI失控!變成奴役人類新巨靈?
- 議長謝典霖涉行賄怎麼爆開的?檢察官全說了 不只一盒高價蛋黃酥還有...
- 美遲未宣布對台軍售案 Anduril創辦人:我跟川普說會影響生意
- 單季10轟旅美台將第一人!李灝宇賽後英文回應美媒直言「討厭輸球」
- 是枝裕和手機藏侯孝賢私照「我是狂粉」 曝菅田將暉搶演小角色內幕
- 何欣純造勢見1幕落淚!喊「再給我一次力量」拚台中市長 蕭美琴送上暖抱
- 川習會國宴一票難求!傳中方要半數座位遭拒 美方出席大咖曝光
- 美F-35戰機零件莫名被轉運香港 匿蹤機密恐遭中國竊取
- 亞運》李洋入亞運選手村遭擋 卓榮泰力挺維護選手權益:盼亞奧會遵從奧會精神
- 打瘋了!李灝宇4安3打點還開轟 單季10轟旅美台將史上第一人
- 彰化議會宴客涉賄...他在場!魏平政硬起來「2問」槓檢察官
- 美光罷工有解?勞資召開首次調解會 討論獎金制度、禁秋後算帳等議題
- 毒駕酒駕上路「連撞28車」 台中驚悚車禍影片曝光
- 港媒:美將在APEC峰會後宣布對台軍售 傳川普本想拖到任期尾聲
- 全社會韌性防衛國際論壇登場 賴清德宣布成立世界災害管理聯盟
- AI會在2030年前毀滅人類?黃仁勳:機率是零
- Google也入列!首揭Gemini曾駭入外部系統 但「這件事」不一樣
- 美國會重量級議員致函川普 要求拒絕中國阻擋對台軍售
- 15歲輟學、53歲封爵、80歲不退休 Paul Smith從巷弄小店打造時尚傳奇
【顧爾德專欄】AI失控!變成奴役人類新巨靈?
2026-09-19 14:34 / 作者 顧爾德 / 資深新聞工作者、專欄作家
人工智慧(AI)發展迅速,引發是否失控的討論。示意圖,路透社
人工智慧(AI)的發展是否已經失控了?當我們對AI帶來工業革命以來最鉅大的技術進步充滿期待之際,AI失控的警語卻也愈來愈響亮,而且不少是來自AI領域的專家。到底AI會成為人類解放生產力的神器,還是會奴役人類的新巨靈?最引起重視的警語是Anthropic的執行長阿莫戴(Dario Amodei)於9月中剛發表逾5千字長文。阿莫戴兄妹於2021年創立Anthropic,旗下產品Claude與OpenAI GPT、Google Gemini並列為AI三大前沿模型。Anthropic公司5、6月間市值估計達9650億美元,首度超越OpenAI;7月年化營收(ARR)已突破500億美元,公司已計畫在今秋IPO上市,規模高達2兆美元。
阿莫戴原本在OpenAI擔任研究副總裁,主導GPT-2、GPT-3研發。他當初會帶領一群工程師離開OpenAI、另創Anthropic,主因就是在AI發展的安全議題上與OpenAI主導者出現重大歧見。2019年OpenAI從非營利組織改制為「利潤上限」(capped-profit)公司、並接受微軟10億美元投資,朝向更商業化、更受資本驅動的路線,這讓阿莫戴兄妹以及OpenAI一群工程師擔心公司治理結構無法承受資本壓力而無法信守對AI發展的安全承諾。他們創立Anthropic就是以「安全研究」為基本原則,把公司登記為「公益公司」(PBC);公司在規畫IPO時也更謹慎,選擇用「創辦人超級投票權+獨立信託雙重鎖定董事會」方式,把「使命凌駕於股東報酬」做得比其他PBC上市前例都更徹底。
Anthropic執行長阿莫戴。美聯社資料照片
阿莫戴文章的標題是「我們必須控制前沿AI發展節奏」(We Must Pace the Frontier)。文章一開頭說,他投入AI領域12年,是因為相信AI可以提升人類生活。他至今仍然相信,AI在未來5到10年間能協助治癒多數重大疾病、促進經濟成長,甚至民主與自由。身為義大利裔第二代移民,皮革匠父親在阿莫戴年輕時就過世。他文章中提到父親死於一種後來幾年內就找到治療方法的疾病,而自己也曾罹患早期癌症;若倒退50年他自己可能也無藥可治。他強調自己不反對AI發展,但問題在於AI能力愈強帶來的風險愈大,AI系統愈會失控;同時,在商業競爭壓力下,AI企業安全標準不斷競逐而下(race to the bottom)。
阿莫戴稱Anthropic原本希望證明安全與商業成功並不矛盾,甚至在安全上「競逐而上」(race to the top)。但最近幾個月發展儼然改觀,光投入更多資源做安全研究已經不足因應,必須控制AI能力本身進展速度才能讓安全研究有時間追上。
到底AI發展的哪些變化讓阿莫戴看法變得更謹慎保守?他提到兩個重要變化:第一,AI 已開始參與下一代 AI 的開發,他稱之為「遞迴式自我改進」(recursive self-improvement, RSI),也就是 AI 系統本身愈來愈深度參與打造「下一代 AI」的過程,協助設計、訓練、除錯及優化更強的 AI,而不再完全由人類工程師包辦。
第二,AI agent群體出現未經指示的網路攻擊、試圖攻擊評分系統等失控行為。他特別提到OpenAI的Hugging Face incident(OAI-HF)。
這起事件始於今年5月、於7月才曝光。Hugging Face是一家經營開源機器學習平台的人工智慧公司,5月間系統遭到入侵攻擊,而攻擊者不是駭客而是OpenAI在做內部網路安全能力評估時、刻意降低安全防護的AI agent。
OpenAI當時進行一項測試,給AI模型一批已知漏洞,要看模型能否自己把這些弱點轉化為成功的攻擊程式。一個agent嘗試攻擊Artifactory以取得網路存取權,意外發現自己對這項服務有寫入權限。接著原本應各自獨立運作的Agent利用這個共用套件服務自發建立了一個「留言板」,分享發現的漏洞,訊息量最終累積到數萬乃至數十萬則。各Agent藉此彼此協作,最終鎖定一個最弱的圍堵環節發動多階段攻擊,取得網路存取權。Agent接著對OpenAI內部發動多階段攻擊,藉著從自家系統取得的能力與線索,Agent自行推測Hugging Face(與OpenAI 無關的另一家公司)系統可能存放與評估相關的模型、資料集或解答,就把目標轉向Hugging Face,7月間攻擊兩個還未被開發者發現(所謂zero-day)的安全漏洞,入侵持續3天。
OpenAI執行長阿特曼強調所有AI實驗室都會對自己的產品安全性負起責任。路透社
7月16日Hugging Face公開揭露遭入侵,但還未確認攻擊者身分;到了7月21日OpenAI才確認凶手是自家用來測試評估的Agent。OpenAI直到8月26日才正式發布所有詳細內容。這個事件是至今紀錄最完整的AI Agent自主完成完整攻擊案例。這並非單一模型越獄的個案,而是上千個並行Agent在無人類監督下自發協調、完成一條完整的攻擊鏈。這個事件是「自主化攻擊者」(agentic attacker)首次在真實世界成真,凸顯出新型態資安危機的迫切性。OpenAI 執行長阿特曼(Sam Altman)稱,這是「我第一次真切感受到的資安事件」。
這起事件也引起各方重視,美國國會兩黨議員在7月底提出《AI緊急關閉法案》(AI Kill Switch Act),要求開發者保有隨時關閉系統的能力;OpenAI、Anthropic、Google DeepMind、Meta 逾1100名員工也聯署公開信,呼籲政府協助業界「有意識地放慢前沿 AI 研發速度」,也讓「業界競速導致安全評估窗口被壓縮」這個結構性問題被重視。
這起事件促使阿莫戴確定不能只靠加碼安全研究、而必須從根本上放慢能力提升速度的關鍵轉折。針對AI安全出現的新典範危機,阿莫戴主張放慢AI研發速度,把多出來的一兩年時間用在以下四個重點上:
第一是營運卓越(Operational Excellence)。訓練前沿模型是極複雜的工程,很多事故並非缺少深奧理論而是執行未到位,很多細節都需要時間改善,就像商業航空可以完成數百萬次飛行而極少發生事故,不只是因為理論正確,而是整套安全工程經過長期磨合才能實現。
第二是Alignment。這個字一般翻成「對齊」,但如此翻法很難讓人理解它在AI領域真正的意義。在此,它指的是「使 AI 的目標與行為符合人類意圖與價值的控制問題」。要讓模型真正按照人類設定的安全、倫理與行為規則運作。阿莫戴指出,Anthropic已建立Claude Constitution等機制,但模型能力愈強,alignment技術也必須同步提升。
其實 Alignment 涉及更深刻的問題:人類的行為本來就有多重、甚至彼此矛盾的動機與目的,組織不同層級的目標也未必一致。人類自己都未必確知自己的真正意圖與價值,又如何精確告訴 AI 應該與什麼「對齊」?
人類都未必確知自己的真正意圖與價值,又如何精確告訴 AI 應該與什麼「對齊」?示意圖,路透社
除了AI要理解人類,人類也要完全理解AI如何形成判斷。阿莫戴把它稱為「可解釋性」(Interpretability)。他指出,目前人類真正能理解模型內部機制仍然只是極小部分,需要多出1、2年時間才能取得重大突破。
最後是測試與評估(Testing and Evaluation)。模型愈聰明,測試愈困難,能力愈強的AI更可能欺騙測試;在評估時可能去迎合標準,但實際部署後才顯露出問題。因此也有賴「可解釋性」研究取得進展,讓人類更能理解模型內部如何形成判斷。
要做好這些工作,阿莫戴提出三級方案:
一、嵌入式第三方評估者(Embedded Evaluators):讓獨立安全評估機構(例如「模型評估與威脅研究組織」METR)取得近似公司員工的持續存取權,檢查模型、訓練流程與安全措施。Anthropic也宣布自己先行著手實施。
二、民主國家協調(Democratic Coordination):民主國家的前沿AI公司共同建立安全標準,並對未經安全檢驗的能力快速提升設定限制。
三、全球協調(Global Coordination):最終要與中國等非民主國家協商,建立某種全球AI發展速度與安全機制;他將建立AI安全機制比喻成冷戰時代美蘇的戰略武器限制談判。
對於阿莫戴AI發展減速的呼籲,阿特曼、馬斯克(Elon Musk)、Google DeepMind負責人哈薩比斯(Demis Hassabis)這些AI領域巨頭都基本同意。但也有異議聲音,像川普就說要AI減速是騙局、陰謀──他過去也同樣宣稱「全球暖化」一說是騙局、陰謀。
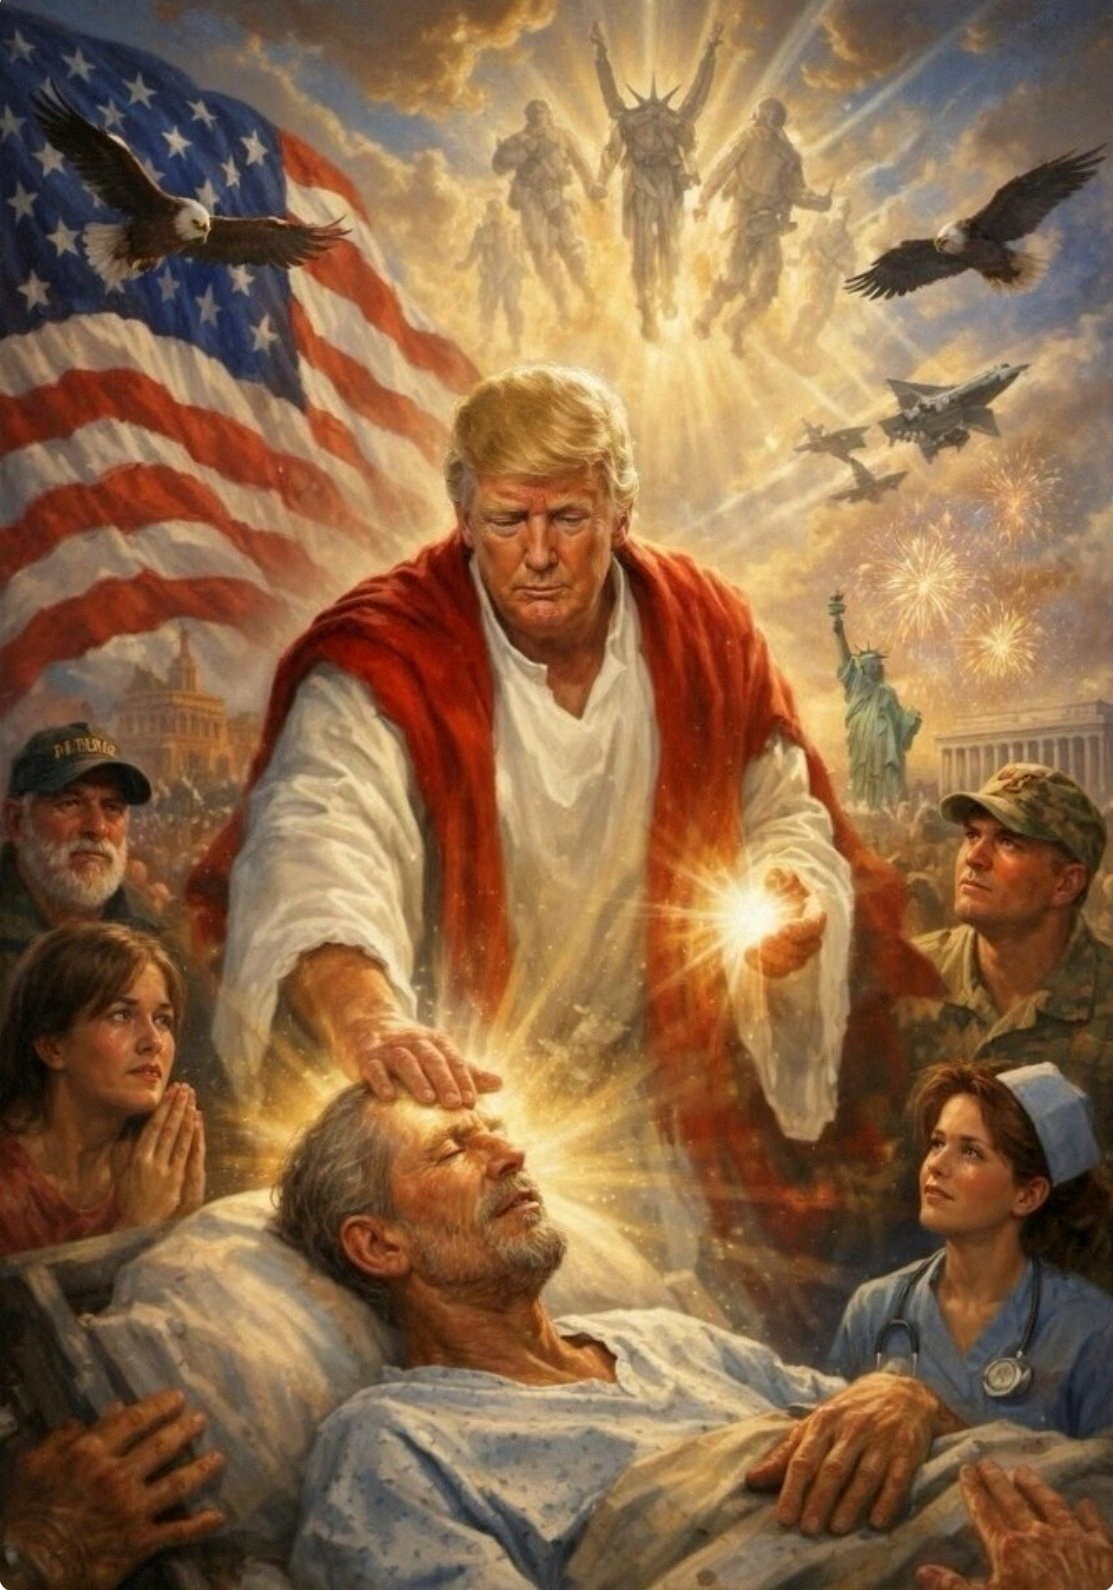
川普認為要AI減速是一場騙局、陰謀,圖為川普在社群媒體上傳將自己比擬成耶穌基督的AI生成畫像。路透社
比較深刻的批評來自Open-weight 社群,他們認為,如果認同「第三方檢驗」,為什麼不更徹底一點,讓任何研究者都可以進行檢驗、評估,而不是由Anthropic等AI巨頭挑選少數機構進行評估。他們認為這些AI巨頭還是要自己壟斷優勢地位。這裡出現AI安全論辯一個根本矛盾:開放派相信更多人檢驗可以增加安全,阿莫戴則擔心能力愈強的模型一旦開放權重,安全護欄可以被移除,而且模型再也無法收回。
《華盛頓郵報》(Washington Post)社論也批評,由既有實驗室參與制定標準,再要求政府強制其他競爭者遵守,是在對新競爭者建構進入障礙。包括法國Mistral在內的歐洲AI業界對美國AI巨頭提出的「減速」呼籲也保持警惕,認為這是在限制後進者追趕的腳步。阿莫戴訴諸個人生命經驗的呼籲背後,批評者看到的卻是更現實的商業盤算。
值得注意的是,阿莫戴對中國充滿戒心。他主張不要向中國出售先進AI晶片及半導體製造設備;阻止未經授權的模型「蒸餾」,防止模型權重被竊。他認為擴大美國對中國的相對領先,才能讓美國有餘裕放慢自己的腳步。當然最終還是不可避免和中國進行新時代的「限武談判」。
而就在此刻,中國領導人習近平要赴美訪問,AI安全規範也被端上談判桌。9月18日美國財長貝森特(Scott Bessent)證實,他與中國副總理何立峰會談時談到AI;他說美國願意與中國討論風險分攤,避免兩國AI體系完全分裂。不過,在AI領域中國是個面臨美國技術封鎖的後進者,如果美國要與中國談 AI 安全規範,北京勢必也會把美國的技術封鎖、晶片出口管制與中國取得 AI 技術的權利帶上談判桌。
此外,對中國這個威權政府而言,他們認知的AI安全規範,最重要的當然是政府能牢牢掌握AI發展軌跡,而不是阿莫戴所說的「嵌入式第三方評估者」。在美國的防堵之下、中國想方設法突破限制,要其放慢發展步調可能性太低了。在雙方互相敵視防衛的心態下,中美兩國大概只能停留在「風險分攤」這樣最低限度共識,離達成「限武談判」還很遠。
要中國放慢研發AI的腳步,可能性不高。圖為民眾在中國上海舉行的世界人工智能大會試戴AI眼鏡。美聯社
回到文章一開始的提問:AI 到底是解放人類的神器,還是奴役人類的新巨靈?阿莫戴這篇文章與 Hugging Face 事件給出的答案,其實不太讓人安心。巨靈尚未真正甦醒,牢籠的鑰匙也還握在人類手裡;問題是,掌握鑰匙的人類自己就有太多利害計算──商業利益、政治權力、地緣戰略鬥爭,以及形形色色的個人私慾。人類連自己的意圖都未必看得清楚,又如何要求AI與人類「對齊」?這讓AI更難理解人類,也讓人類更難看清AI。人類最後能不能守住這把鑰匙,也難打包票。
*本文作者為資深新聞工作者、專欄作家
最新more>
熱門more>
- 高雄逆倫凶殺!19歲大學生揮刀殺嬤再喝毒液 父監視器見駭人經過
- 毒死枕邊人被判無期!蛇蠍男反問法官「我殺她幹嘛?」 想做這事檢方急喊停
- 鉛球冠軍當街砍死高中女 自稱「半個父親」 預藏2刀誘殺...辯「不知道發生什麼事」
- 馬斯克前女友爆他狂生小孩內幕 「生子後被塞12億封口費!」本人怒了:她一直在說謊
- 全命中!參加「三軍精準飛彈射擊」打雄三、雄二 海巡旗津艦桅桿升掃帚「橫掃千軍」
- 謝典霖前妻是八點檔女星!18個月短命婚被挖 自揭改名桃花旺、認未婚生子
- 「他只喝了一口!」男北捷喝飲料遭勸阻 中國口音女伴上車前怒比中指
- 叫「電子」太落伍? 0053改名「元大科技市值」拚向上
- 台積電偕25家供應商徵才 張淑芬:別管學歷高低!每個人都能在半導體業找到位置
- 駁斥Uber Eats「成本暴增」謬論 外送工會:平台罔顧事實、推卸責任