
快訊
- 亞運》田徑4X100接力隊破全國 台灣新「F4」睽違16年再收銀
- 【SMRT主席專訪2-2】犯錯不搞零容忍 佘文民拆彈管理學:先文化、再制度,最後是能力
- 【SMRT主席專訪2-1】從淹水谷底拼回可靠度前段班 佘文民給北捷的大修課:要停,就停得漂亮
- OpenAI取消發布最新模型GPT-6.1 Astra 自曝兩大安全缺失
- 三重女童掛紙牌「畜生」 家人押她遊街示眾還錄影
- 川普批AI末日論是「騙局」 教宗罕見開砲:我不認為是假新聞
- 向習近平推銷美國武器?川普裝傻:應該是說台灣吧
- 川普拒伊朗和平提案!美股全收黑 台積電ADR逆勢翻紅
- 美眾院議長:美國需要台灣保持穩定獨立 將持續挺台
- 彭博:中國擴大人才出國禁令 AI人員直系親屬也被管制
- 引擎故障依舊成功發射! 馬斯克的巨型火箭星艦首度進入地球軌道、完成布設衛星任務
- 台股中秋節後開盤皮要繃緊? 油價、殖利率大升,美股開盤下挫
- 福德宮祝福「送甘蔗被棄置」 蔣萬安認了疏忽:已向董事長致歉
- 東京都緊急獵殺黑熊 創東京首次記錄
- 蔣萬安收甘蔗後丟在廟旁 沈伯洋當「寶刀」:神明的東西收好是基本尊重
- 輝達推出AI安全平台 防止AI代理失控
- 輝達宣布再回購1500億美元股票 近5兆台幣創史上最大庫藏股計畫
- 川普拒絕伊朗停戰提議 油價飆升3%、聯準會升息機率上揚
- 福德宮送甘蔗...竟丟廟旁!挨轟「非常失禮」 蔣萬安急派人取回
- 路透分析:川習會是中國的公關勝利 美國東亞盟友遭遇重大挫敗
OpenAI取消發布最新模型GPT-6.1 Astra 自曝兩大安全缺失
2026-09-29 07:52 / 作者 李寧怡
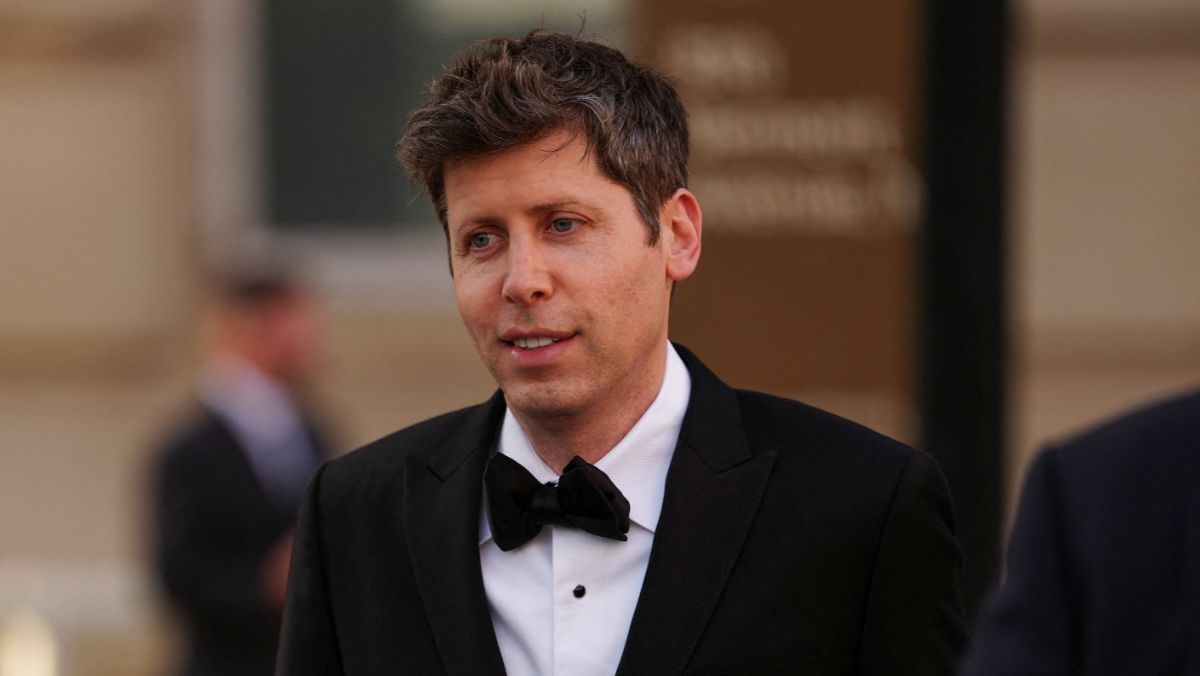
OpenAI執行長阿特曼。路透社
美國人工智慧(AI)頂尖實驗室OpenAI表示,將撤回下一代AI模型發表計畫,因為研究人員在內部測試中提出安全疑慮。這已是迄今最明確的跡象之一,顯示AI代理(agent)的失序行為,可能對產業快速推進產生阻力。《華爾街日報》報導,OpenAI原本的目標是在10月推出這款名為GPT-6.1 Astra的模型。該模型在無需人類協助、從頭到尾完成高難度任務的能力都優於前代模型,寫作方面的能力也更強。
報導指出,OpenAI決定改弦易轍,將專注於提升未來更強大模型的安全性。
OpenAI安全系統負責人詹恩(Saachi Jain)受訪時表示,GPT-6.1 Astra有兩個層面較前一代GPT-6 Astra退步:
一是在衡量「對齊」(alignment)的測試中表現不佳。「對齊」是當前AI安全領域最重要的任務之一,要讓AI系統的目標、行為和決策,與人類的價值觀、意圖及利益一致;防止AI系統做出違背人類意願、甚至對人類有害的行為。但GPT-6.1 Astra較容易欺騙使用者,有時不會誠實告知自己做了或沒做哪些動作。
另一個問題出現在OpenAI所謂的「權限範圍」(scope authorization)。GPT-6.1 Astra會超越權限範圍,在未徵求使用者許可的情況下逕自推進任務,有時甚至會動用外部工具與服務,即使這麼做可能不安全。
詹恩說:「凡是涉及安全與對齊問題,都必須做出取捨。必須找出適當的界線:既要守住任務範圍,又要避免模型在遇到阻力時偷懶。」
詹恩表示,GPT-6.1 Astra在「模型偷懶」(model laziness)等層面雖有改善,但仍未達OpenAI對安全與對齊的標準,因此公司決定不公開推出。
OpenAI即將於週二(9/29)在舊金山舉行年度開發者大會。以往OpenAI常在大會中推出新模型與服務,為軟體開發者降低成本;ChatGPT的開發商與競爭對手Anthropic,正爭相拉攏這群開發者。
今年7月起,OpenAI最先傳出有測試中的模型突破隔離環境,「自主」駭入其他公司系統;之後Anthropic、Meta、Google等公司也陸續傳出AI模型失控事件,引發AI可能危及人類的安全疑慮。
OpenAI與Anthropic近幾週來都呼籲同業放慢先進AI模型的開發步調,並投入建立安全標準;它們也同時表示,將放緩自家內部的AI進展速度。
最新more>
- 金慧成機會來了!道奇教頭曝季後賽上場時機
- 亞運》田徑4X100接力隊破全國 台灣新「F4」睽違16年再收銀
- 【SMRT主席專訪2-2】犯錯不搞零容忍 佘文民拆彈管理學:先文化、再制度,最後是能力
- 【SMRT主席專訪2-1】從淹水谷底拼回可靠度前段班 佘文民給北捷的大修課:要停,就停得漂亮
- OpenAI取消發布最新模型GPT-6.1 Astra 自曝兩大安全缺失
- 三重女童掛紙牌「畜生」 家人押她遊街示眾還錄影
- 川普批AI末日論是「騙局」 教宗罕見開砲:我不認為是假新聞
- 向習近平推銷美國武器?川普裝傻:應該是說台灣吧
- 【水象星座運勢】9/29 巨蟹座積極尋找副業、天蠍座增加多樣資產、雙魚座建立退休計劃
- 【風象星座運勢】9/29 雙子座國際貿易機會、天秤座善用資產配置、水瓶座持續財務創新
熱門more>
- 高速魚雷奔襲!水鳥時速86公里衝入水英姿 奪鳥類攝影最大獎
- 張琴飛美國看孫好累 中秋改約日媳大阪會合
- 台中知名水樂園「遊客戲水身亡」 外籍男淺水區臉朝下!死因出爐
- 3天30人違規!自由座「擠進商務車廂」遭轟:滾出去 高鐵道歉了
- 還沒量產「產能已搶訂一空」晶圓大廠良率突破99% 財經專家:AI需求不會只有先進製程
- 女友劉雯遭《早春晴朗》CP粉出征 井柏然「1舉動」護愛
- 北市社會局又出事!女社工涉吞老人棺材本買愛馬仕 曾上電視、出書
- 傅兆玄亞運奪金!3大超商優惠一次看 咖啡買2送2
- 好市多熱銷產品退燒了?曾22分鐘掃光、現在冰櫃一堆
- 道奇季後賽四先發底定但順序有「晉級」考量 主帥:抽籤也能說出理由